Le pipeline de vente est l'un de ces sujets que tout le monde pense maîtriser, jusqu'au moment où on vous tend un fichier CSV avec 300 lignes, trois formats de date différents et des noms d'entreprise écrits de six façons. C'est exactement le genre de problème que j'ai voulu résoudre aujourd'hui, et je l'ai fait en construisant un SaaS complet de gestion de pipeline avec GenSpark.
Le problème que je rencontre constamment quand je construis un logiciel avec l'IA, c'est que j'avais besoin d'un outil différent pour presque chaque étape du processus. Un modèle pour rechercher l'idée, un autre pour planifier le produit, un autre pour écrire le code, puis autre chose pour les données. Et ils ont tous leur propre contexte, donc je ré-explique constamment le même projet. C'est ce qui rend GenSpark intéressant, parce qu'il rassemble tous les meilleurs modèles d'IA au même endroit.
Plutôt que de regarder une série de fonctionnalités d'IA individuelles, on va vraiment construire quelque chose. On part d'une idée, on utilise GenSpark pour rechercher et planifier le produit, construire le SaaS, intégrer un jeu de données de vente et le structurer, analyser ces données, mettre une équipe entière d'agents IA dessus, et continuer à itérer jusqu'à avoir quelque chose que je pourrais réalistement mettre devant un utilisateur.
Trouver une idée qui résout un vrai problème
Avant d'écrire une seule ligne de code, il faut un vrai produit à construire. Je ne veux pas passer des heures à inventer une idée dont personne n'a besoin. Je commence dans GenSpark avec Super Agent et je lui donne un objectif simple.
Je veux un produit SaaS pour un problème spécifique, et je veux que GenSpark recherche le marché, examine les produits existants, comprenne ce avec quoi les utilisateurs galèrent, et revienne avec quelques idées qui pourraient fonctionner comme un petit MVP. Je n'ai pas à décider quel modèle gère la recherche et lequel analyse les résultats. Je décris simplement le travail et GenSpark le décompose en étapes.
Une fois la recherche terminée, on obtient quelques idées avec les concurrents, les utilisateurs et les lacunes dans les produits existants. J'en choisis une qui est un MVP assez simple à construire, mais avec suffisamment de substance pour ressembler à un produit.
Ensuite, je prends cette recherche et je demande à GenSpark de la transformer en plan produit. Je lui fais définir le flux utilisateur principal, les fonctionnalités clés, les pages nécessaires pour le MVP et le type de données que l'application doit stocker. C'est un autre moment où tout avoir ensemble aide, parce que je n'ai pas à copier la recherche dans un autre modèle et ré-expliquer l'idée.
Le plan produit est prêt : le flux utilisateur, les écrans, la fonctionnalité de base et une définition claire de la première version. Je garde le périmètre petit parce que je veux quelque chose qu'on peut vraiment faire fonctionner. Pour être sûr de ne pas perdre le document de plan, je demande au Super Agent de le convertir en fichier docx et de me l'envoyer par email.
Construire l'application, pour de vrai
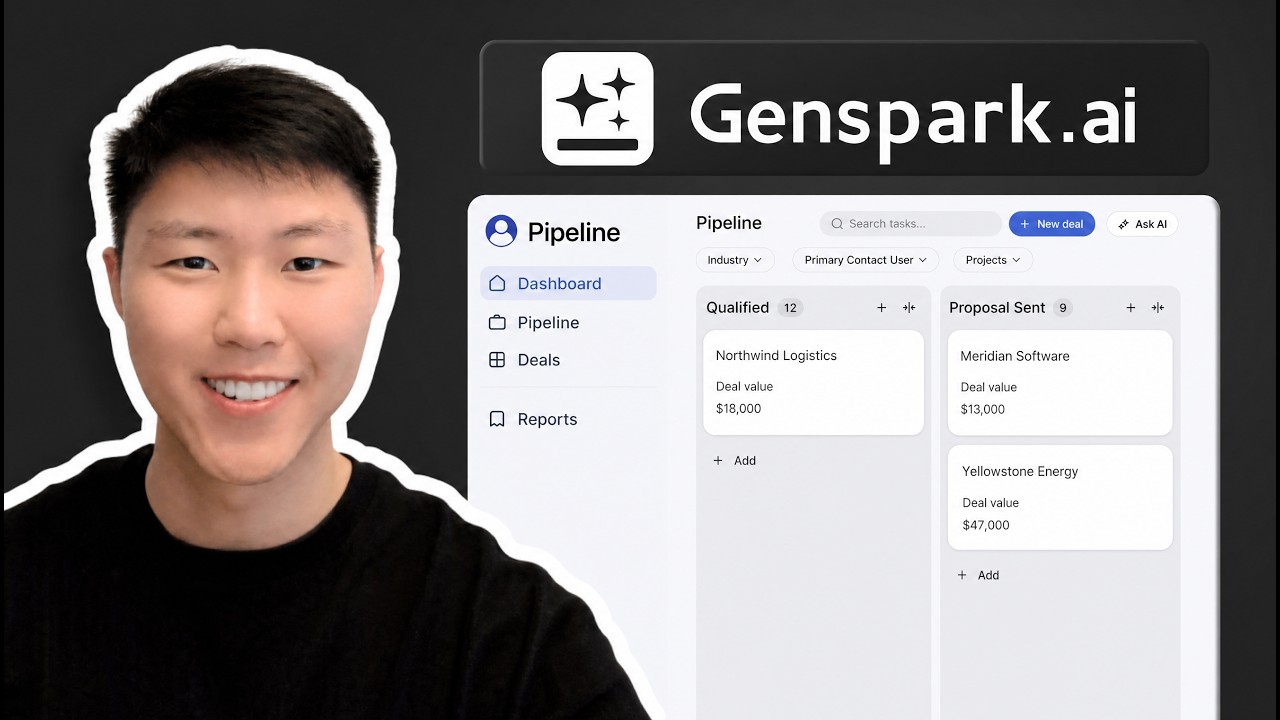
J'ouvre GenSpark Code et je lui donne le plan produit. Je suis précis sur ce qu'on demande parce que tout le produit repose sur quelques éléments. On a besoin d'une liste d'opportunités de vente, et chaque opportunité a un nom de client, une valeur de deal, un propriétaire et une étape dans le pipeline. On a besoin d'un tableau de pipeline où je peux déplacer un deal d'une étape à la suivante : qualifié, proposition envoyée, négociation, gagné ou perdu. Et on a besoin d'un tableau de bord en haut montrant la valeur totale du pipeline et combien de deals se trouvent à chaque étape.
Au lieu de simplement me donner du code à configurer moi-même, GenSpark donne à l'agent un environnement de développement où il peut créer les fichiers, configurer la base de données, exécuter l'application et tester ce qu'il construit. On ne part pas d'un chat de codage vide, parce que la recherche et le plan produit font déjà partie de ce flux de travail.
La première version est prête. J'ouvre l'aperçu et je l'utilise vraiment plutôt que de simplement la regarder. Je clique sur "Ajouter un deal manuellement". Le client est Northwind Logistics, la valeur du deal est de 18 000 $. Je définis le propriétaire et je le mets dans "Qualifié". Il apparaît comme une carte dans la colonne qualifié. Ensuite, je fais glisser ce deal de "Qualifié" vers "Gagné". Les compteurs d'étape se mettent à jour sur les deux colonnes et la valeur totale du pipeline se recalcule. Les étapes ne sont pas juste des étiquettes. L'application suit le deal et les chiffres du tableau de bord proviennent des enregistrements sous-jacents.
Ce n'est évidemment pas fini, mais on est passé d'une idée à une recherche, à un plan produit, à une application fonctionnelle sans changer complètement d'outil d'IA.
Injecter des données réelles (ou presque)
L'application est essentiellement vide. Il n'y a que le deal que je viens d'ajouter. On a besoin de vrais enregistrements de vente qui circulent dedans. Je n'utilise pas le pipeline d'une vraie entreprise. Tout ce que vous voyez, ce sont des données de vente d'exemple que j'ai assemblées pour cette construction. C'est un CSV désordonné, quelques centaines de lignes, des noms d'entreprise incohérents, des champs vides, des dates dans trois formats différents. En gros, le genre de fichier qu'on vous tendrait vraiment.
Pour ça, j'utilise Agent Base. Je télécharge ce fichier et je lui dis exactement ce que je veux : une table d'opportunités de vente, et chaque enregistrement doit avoir un nom de client, le propriétaire du deal, la valeur du deal, l'étape actuelle, la date du dernier contact et la date du prochain suivi. Et qu'il standardise les noms d'entreprise et corrige les dates au passage.
Le résultat : des enregistrements structurés avec ces champs exacts, tous nettoyés et cohérents. Je peux lire ça comme une table, passer en vue Kanban pour voir les deals regroupés par étape de pipeline, ou ouvrir la vue tableau de bord pour les chiffres de plus haut niveau. Mais je ne veux pas que ça reste dans Agent Base comme un tableau de bord séparé. Je retourne dans GenSpark Code et je lui demande de prendre directement la base de données qu'Agent Base vient de créer. Si je rafraîchis l'aperçu, toutes ces opportunités apparaissent sur le tableau de pipeline. Les colonnes d'étape sont remplies, chaque carte a le nom du client et la valeur du deal, et le total en haut est calculé à partir de ces enregistrements.
On ne fait pas que générer un front-end avec des lignes factices. Les données ont commencé désordonnées, Agent Base les a structurées, et ces mêmes enregistrements sont maintenant dans l'application et alimentent les chiffres à l'écran. Ce sont des données d'exemple, pas le pipeline d'un vrai client, mais le chemin qu'elles ont emprunté pour y arriver est le même que celui que vous utiliseriez avec votre propre fichier.
Analyser pour trouver ce qui coince
Je veux faire plus qu'afficher ces données. J'apporte les mêmes enregistrements dans AI Sheets. Au lieu d'écrire des formules, je décris simplement l'analyse. Je demande trois choses.
D'abord, la valeur totale des deals par étape, pour voir combien d'argent se trouve dans "Qualifié" par rapport à "Proposition envoyée" par rapport à "Négociation". Ensuite, notre taux de réussite : sur tous les deals qui sont réellement conclus, quel pourcentage est revenu comme "Gagné" ? Et troisièmement, une liste des opportunités qui nécessitent un suivi, c'est-à-dire tout deal dont la date de prochain suivi est déjà passée ou qu'on n'a pas touché depuis deux semaines. Puis un graphique en barres pour la valeur par étape et un camembert pour gagné contre perdu.
La feuille de calcul terminée donne de vraies réponses. En regardant la valeur par étape, la majeure partie de la valeur de notre pipeline se trouve dans "Proposition envoyée", ce qui me dit que les deals ne meurent pas tôt, ils calent juste avant la négociation. Et ensuite, la liste que je voulais vraiment : les opportunités dont la date de suivi est déjà passée. Il y en a beaucoup plus que ce à quoi je m'attendais. Cette dernière liste est une liste de choses à faire, et ce blocage au niveau des propositions est un problème produit pour lequel je peux concevoir une solution.
Une équipe d'agents IA qui travaille ensemble
Jusqu'ici, tout a été moi qui pilotais un agent à la fois, et ça fonctionne. Mais il y a une partie de GenSpark que je voulais vraiment tester sur cette construction : GenTeam. GenTeam me donne un espace de travail qui ressemble beaucoup à un canal Slack, sauf que les personnes dedans sont des agents IA que je définis et ils peuvent tous voir le canal et se parler entre eux.
Je crée un canal pour ce projet et j'ajoute trois agents, chacun avec son propre rôle. Un analyste de données pour travailler avec les enregistrements de vente et en extraire les chiffres, un responsable commercial pour décider quels deals nécessitent vraiment une action cette semaine, et un développeur pour transformer ce que les deux autres trouvent en modifications pour notre SaaS. Ensuite, au lieu de les piloter un par un, je donne à tout le canal une seule tâche.
Je poste dans le canal, je tague les trois, je joins les données de vente et je demande une revue hebdomadaire du pipeline : où la valeur du pipeline est bloquée, les deals spécifiques qui nécessitent un suivi cette semaine, des brouillons d'emails prêts à être envoyés pour ces deals, et une courte liste de modifications à apporter à l'application.
C'est la partie qui vaut vraiment le coup d'être regardée. J'ai envoyé un seul message, mais vous pouvez les voir se parler dans le canal, chacun reprenant là où le précédent s'est arrêté. Ce n'est pas trois agents qui répondent à la même invite dans trois onglets séparés. Ils lisent et construisent réellement sur le travail des autres. Le développeur donne une déclaration initiale. Le responsable commercial enchaîne en faisant correspondre ses résultats avec le message du développeur. Et ensuite l'analyste de données donne sa décomposition. À la fin, on obtient un seul résultat.
Voici la revue de pipeline terminée avec la valeur décomposée par étape, les deals qui nécessitent un suivi cette semaine, les brouillons d'emails prêts à être envoyés, et la liste des modifications produit. C'est ce que j'obtiendrais d'une réunion d'équipe, sauf que j'ai envoyé un message et j'ai regardé ça se produire.
Itérer sur le produit avec ce qu'on a appris
Maintenant que j'ai la liste, je demande au développeur d'implémenter les modifications. En plus de ça, je lui demande de faire des modifications supplémentaires. Je veux que la valeur totale du pipeline et le taux de réussite soient remontés en haut du tableau de bord pour que ce soit la première chose qu'on voit. Je veux une section "Nécessite un suivi" sur l'écran principal qui fasse remonter tout deal dont la date de prochain suivi est passée. Et je veux que ces mêmes deals soient mis en évidence sur le tableau de pipeline pour qu'on puisse les repérer sans rien ouvrir.
Voici la version mise à jour. Même fonctionnalité de base, mais le tableau de bord répond aux questions qu'on se posait dans la feuille de calcul, et les deals qui nécessitent de l'attention sont ceux que l'application met en avant devant vous.
Cette revue de pipeline n'est pas un événement ponctuel. C'est quelque chose que j'exécuterais chaque semaine sur de nouvelles données. Au lieu de repartir de zéro à chaque fois, je vais en faire une compétence réutilisable dans GenSpark, que je vais appeler "Revue de pipeline de vente". Je crée ma propre compétence ici, mais GenSpark a déjà des centaines de compétences prêtes à être utilisées. Vous pouvez obtenir des compétences pour la vente, le marketing, le design, la recherche, et plus encore.
Je définis ce qu'elle fait. L'entrée est un ensemble d'enregistrements de vente avec un nom de client, une valeur de deal, une étape actuelle et une date de prochain suivi. Et la sortie doit être trois choses à chaque fois : un résumé du pipeline par étape, une liste des deals qui nécessitent un suivi, et un brouillon d'email de suivi pour chacun de ces deals. Ensuite, je lui donne les étapes, c'est-à-dire le processus qu'on vient de parcourir manuellement.
La compétence est sauvegardée, mais le vrai test est de l'exécuter sur quelque chose qu'elle n'a jamais vu. J'ai un deuxième jeu de données d'exemple ici, un ensemble complètement différent d'enregistrements de vente. Au lieu de ré-expliquer tout ça, j'appelle simplement la compétence et je la pointe vers le nouveau fichier. Et voilà. Les trois mêmes sorties sur des données qu'elle n'a jamais vues. C'était une seule invite au lieu de tout l'aller-retour qu'on a fait la première fois.
Une autre chose que je peux faire, c'est aller dans la fonctionnalité AI Slides de GenSpark et lui demander de faire un résumé sous forme de diapositives visuelles. Les résultats de la sortie qu'on a obtenue de la compétence qu'on vient d'utiliser, au format diapositives. Facile à consulter.
Points clés à retenir
- Un seul espace de travail change tout : la recherche, la planification, le codage, la structuration des données, l'analyse et la revue d'équipe se sont tous déroulés dans GenSpark, sans avoir à déplacer le contexte entre différents outils.
- Les données désordonnées ne sont pas un obstacle : un CSV avec des formats incohérents et des champs vides a été nettoyé et structuré par Agent Base, puis injecté directement dans l'application pour alimenter les vrais chiffres du tableau de bord.
- L'analyse révèle les vrais problèmes : la majeure partie de la valeur du pipeline bloquait dans "Proposition envoyée", pas dans les étapes précoces, et la liste des suivis en retard était bien plus longue que prévu.
- Une équipe d'agents IA peut collaborer en temps réel : avec GenTeam, trois agents avec des rôles distincts ont lu et construit sur le travail des autres dans un canal partagé, produisant une revue de pipeline complète à partir d'un seul message.
- Transformer un processus en compétence réutilisable : la revue de pipeline a été sauvegardée comme compétence et exécutée sur un fichier de données totalement nouveau en une seule invite, produisant les mêmes trois sorties sans répéter le travail manuel.
Ce qui ressort de tout ça, ce n'est pas une fonctionnalité unique de GenSpark. C'est que toutes ces étapes se sont produites dans le même espace de travail. On a recherché le marché, planifié le produit, construit le SaaS, structuré un jeu de données désordonné et l'a intégré dans l'application, on l'a analysé, on a demandé à une équipe d'agents IA de revoir le pipeline ensemble, et on a utilisé ce qu'ils ont trouvé pour améliorer le produit. Normalement, je devrais sauter entre plusieurs outils d'IA différents pour ça et déplacer le contexte entre eux à chaque fois.
Si vous utilisez l'IA pour le développement, la recherche, l'analyse de données ou beaucoup de travail répétitif, c'est là que GenSpark vaut le coup d'être essayé. Vous n'avez pas nécessairement besoin d'un abonnement séparé pour chaque partie de votre flux de travail.